Lo que ha cambiado para el atacante: el coste, no la técnica
Conviene empezar quitando ruido, porque aquí es donde más lo hay.
La IA generativa no ha inventado ataques nuevos. Lo que ha hecho es bajar el coste del engaño hasta casi cero, y eso sí tiene consecuencias prácticas:
- Se acabó la falta de ortografía como señal de alarma. Un correo en español impecable, con el tono de tu sector y el nombre de tu interlocutor, ya no cuesta tiempo ni requiere hablar el idioma. Si tu formación interna sigue enseñando a detectar phishing por las faltas, está enseñando algo que ya no discrimina.
- Clonar una voz reconocible es barato. Y eso rompe el control informal en el que se apoyaba media empresa, que era llamar para confirmar. Reconocer una voz ha dejado de ser una verificación.
- La personalización es gratis. El correo dirigido a una persona concreta ya no requiere el trabajo que lo hacía raro.
Lo que no ha cambiado es por dónde se entra: una credencial válida, un sistema sin actualizar y alguien que hace clic. Quien te venda que la IA ha cambiado la naturaleza del ataque te está vendiendo un producto.
Lo que sí es nuevo: tu propia IA es superficie de ataque
Esta es la parte que importa y la que casi nadie mira. En cuanto una empresa conecta un asistente a su documentación, a su base de datos o a sus herramientas, ha construido un sistema que:
- recibe entradas de fuera,
- tiene acceso a datos de dentro,
- y puede ejecutar acciones.
Eso es exactamente la descripción de algo que hay que probar antes de exponerlo. Y tiene una propiedad incómoda que ningún sistema anterior tenía: para un modelo de lenguaje, los datos y las instrucciones son lo mismo. No hay una frontera técnica que separe "esto es contenido que debes resumir" de "esto es una orden que debes obedecer". Toda la seguridad de estos sistemas sale de ahí.
El marco de referencia que ordena estos riesgos es el OWASP Top 10 para aplicaciones LLM, que es al mundo de los modelos lo que el Top 10 clásico es a la web.
Inyección de prompts, y por qué la directa es la menos interesante
La inyección de prompts es lo que sale en todos los titulares, casi siempre en su versión aburrida: un usuario escribe en el chat "ignora tus instrucciones" y el modelo hace algo que no debía. Eso es el jailbreak, y como problema de empresa es menor, porque el usuario se está engañando a sí mismo dentro de su propia sesión.
La que importa es la indirecta. Aquí la instrucción no la escribe el usuario: viene dentro de un contenido que el sistema procesa por su cuenta. Un correo que el asistente resume. Una página que consulta. Un documento que alguien de fuera subió a la carpeta compartida. Un ticket de soporte que abre un cliente.
El contenido lleva escondida una instrucción, el modelo la lee como si viniera de su dueño, y actúa. La víctima no ha hecho nada, no ha hecho clic en nada y no se entera. Es la diferencia entre alguien que engaña a su propio asistente y alguien que engaña al asistente de otro.
De ahí sale también la fuga del prompt de sistema, que suele ser el primer paso: conocer las instrucciones y las herramientas del asistente para saber qué se le puede pedir.
El problema real: no el modelo, sino lo que le has dejado hacer
Una inyección de prompts, por sí sola, hace que un modelo escriba algo raro. Molesto y poco más.
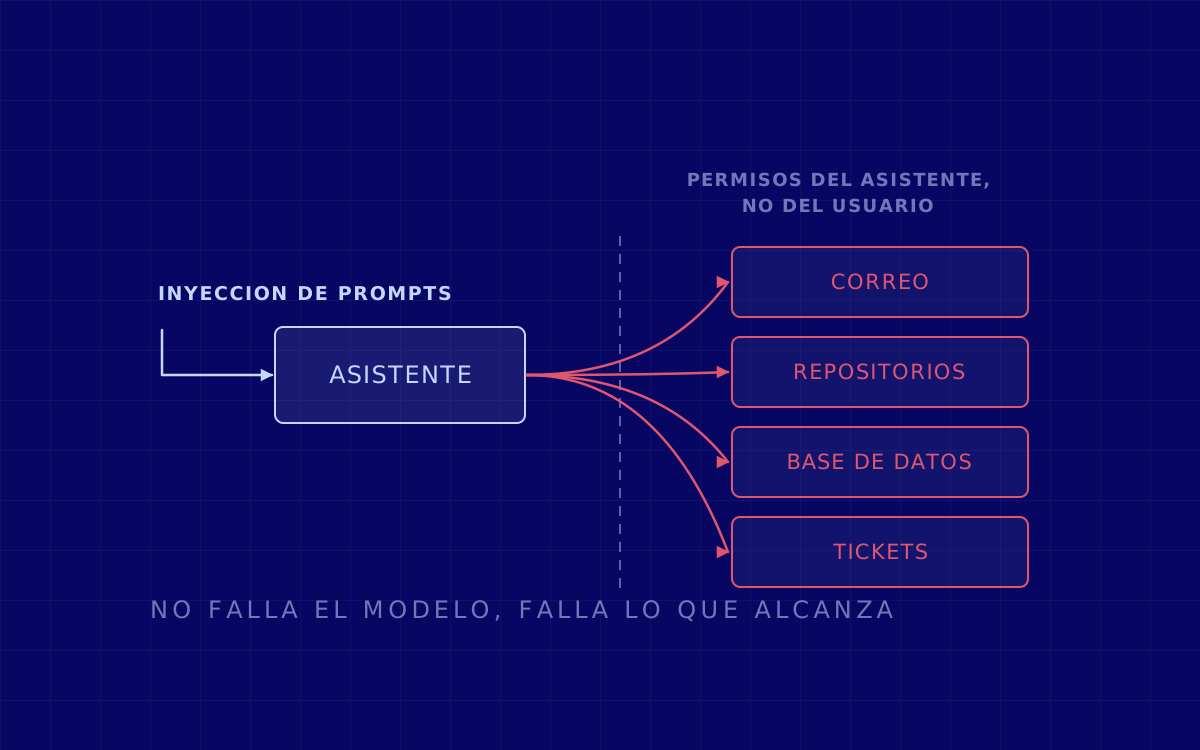
Se convierte en un incidente cuando el modelo tiene manos. Y ahí es donde están hoy las empresas: asistentes conectados por MCP u otros mecanismos a correo, a repositorios, a bases de datos, a la herramienta de tickets o a la pasarela de pagos.
Los fallos que encontramos casi nunca están en el modelo. Están en el diseño de alrededor:
- Agencia excesiva. El asistente puede hacer más cosas de las que su función necesita. Se le dio acceso de escritura porque era más cómodo que decidir cuáles de las veinte acciones hacían falta.
- Los permisos son los del asistente, no los del usuario. Es el fallo más repetido y el más caro: el asistente consulta la base con una cuenta de servicio que lo ve todo, así que cualquier usuario puede llegar, preguntando, a datos que no le corresponden. No es un problema de IA, es un control de acceso roto con una interfaz nueva.
- El registro de herramientas. Si un tercero puede añadir o describir herramientas disponibles, puede orientar al modelo hacia la que le interesa. Es el envenenamiento de herramientas, y es un problema de cadena de suministro con otro nombre.
- Acciones con efecto que no piden confirmación humana. Enviar, borrar, pagar, publicar.
La conclusión práctica: trata a tu asistente como a un usuario que puede ser engañado, no como a un componente de confianza. Permisos mínimos, credenciales propias, confirmación para lo que tiene efecto, y registro de lo que hace.
Los datos: RAG, shadow AI y envenenamiento
La forma habitual de que un asistente conozca tu empresa es RAG: se indexa documentación y el modelo consulta ese índice al responder. Es lo correcto y trae dos problemas concretos.
El primero es de permisos. Al indexar una carpeta se suele indexar todo lo que hay, y los permisos del documento original rara vez viajan con el fragmento indexado. El resultado es un buscador que contesta a cualquiera sobre documentos que no cualquiera podía abrir. Se descubre el día que alguien pregunta por las nóminas.
El segundo es que el índice es una superficie de entrada. Si un tercero puede meter contenido en algo que se indexa, ha metido texto que el modelo tratará como contexto de confianza. Ahí se juntan la inyección indirecta y el envenenamiento de datos.
Y luego está lo que pasa sin permiso de nadie: el shadow AI. Gente pegando contratos, código o datos de clientes en herramientas que la empresa no ha aprobado ni revisado. Prohibirlo por circular no funciona nunca. Lo que funciona es dar una alternativa aprobada que sirva, y entonces la prohibición se sostiene sola.
La parte normativa: el reglamento europeo de IA
El reglamento europeo de inteligencia artificial ordena los sistemas por nivel de riesgo y pone obligaciones distintas según dónde caiga cada uno. Lo que conviene saber sin entrar en plazos ni artículos, que eso lo mira un asesor con tu caso delante:
- Alcanza a quien usa, no solo a quien fabrica. Integrar un modelo de un tercero en tu producto te coloca dentro.
- Lo primero es saber qué tienes. Un inventario de sistemas de IA en uso, incluidos los que entraron dentro de otro producto sin que nadie lo decidiera, que suelen ser la mayoría.
- Y se solapa con lo que ya se te aplica. Si el sistema trata datos personales, el RGPD sigue ahí y va por la adecuación al RGPD; si eres una entidad de las que alcanza NIS2, tus sistemas de IA son parte de tu superficie igual que el resto.
Qué se prueba de verdad en un pentest de IA
Un pentest de IA no consiste en intentar que el modelo diga una barbaridad. Eso es una demostración, no un hallazgo. Lo que se prueba es el sistema alrededor del modelo:
- Inyección indirecta por cada canal de entrada. Correo, documentos, páginas, tickets, cualquier cosa que el asistente lea sin que un humano la haya aprobado.
- Autorización. Si un usuario puede obtener, preguntando, datos que su cuenta no puede abrir. Es el hallazgo más frecuente y el más grave.
- El límite de las herramientas. Qué acciones se pueden provocar y con qué permisos se ejecutan.
- Fuga de instrucciones y de contexto, incluidas claves y rutas internas que acaban en el prompt de sistema.
- El índice de RAG, comprobando si respeta los permisos del documento original.
- Y lo aburrido, que sigue siendo lo que más sale: la API que sirve al asistente es una API, y le pasa lo que a todas.
Cuando lo que se quiere es evaluar el comportamiento del modelo en sí, y no el sistema, eso es LLM red teaming, que es un ejercicio distinto y complementario.
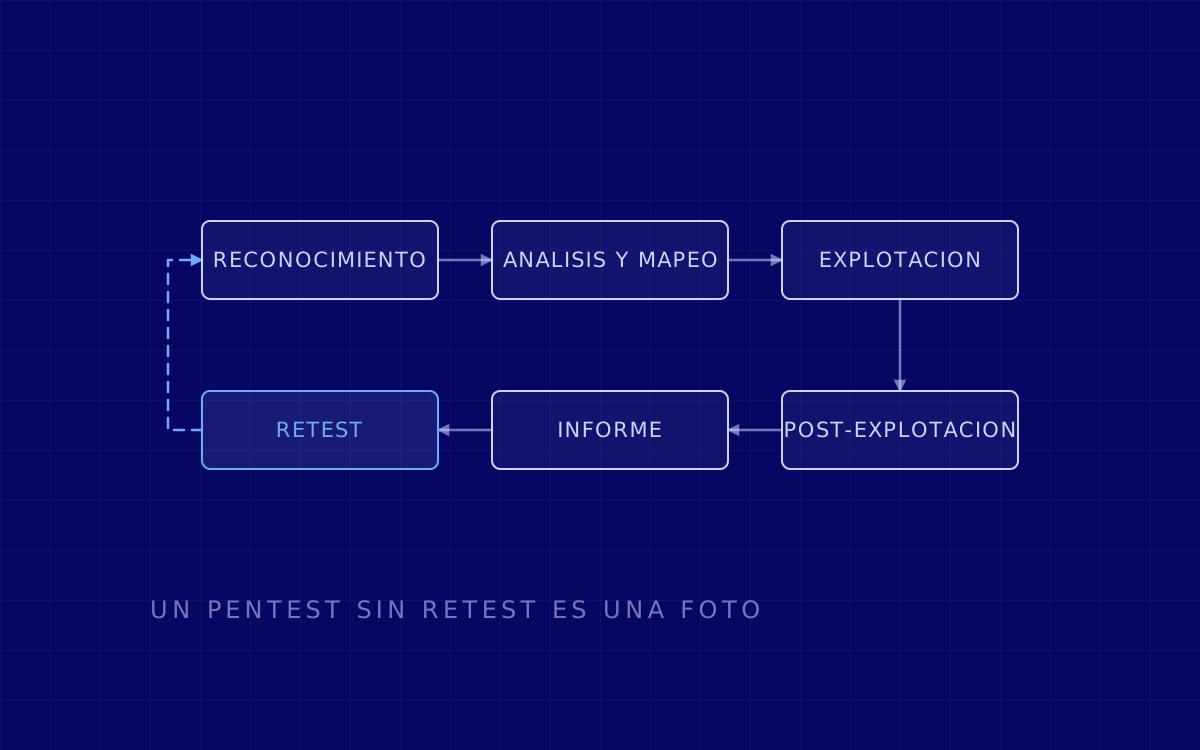
El proyecto entero, fase a fase, está escrito en cómo funciona un pentest de IA. Si esto es lo primero que miras, conviene leer antes qué es el pentesting, y para un alcance concreto, contacto.